

DeepSeek(深度求索)是一家成立於 2023 年的中國 AI 公司,也是一系列大型語言模型與 AI 服務的名稱。2025 年的 DeepSeek-V3、DeepSeek-R1 讓市場注意到它的低成本訓練與推理能力;截至 2026 年 10 月,官方 API 已更新到 DeepSeek-V4.1-Flash 與 DeepSeek-V4-Pro,支援 100 萬 token 的上下文,以及一般回答與思考模式。這篇文章保留 V3、R1 的發展脈絡,同時把現行模型、功能與價格更新為官方最新資料。
什麼是大語言模型(LLM)?
大語言模型的英文是 Large Language Model,簡稱 LLM,是一種從大量文字與其他資料中學習規律、用來理解及生成內容的 AI 模型。ChatGPT 是 OpenAI 的 AI 服務,Gemini 是 Google 的模型與服務品牌,DeepSeek 則是公司、服務與模型家族的名稱,三者不能直接當成同一層級的「模型名稱」。
DeepSeek 是一家什麼公司?
深度求索(DeepSeek)是一家成立於 2023 年的中國 AI 公司,官方長期目標是推進通用人工智慧(AGI)。產品包含網頁與手機版 DeepSeek Chat、API 平台及可下載的模型權重;現行服務可用於文字與程式生成、推理、翻譯、資料整理、工具呼叫與視覺理解。
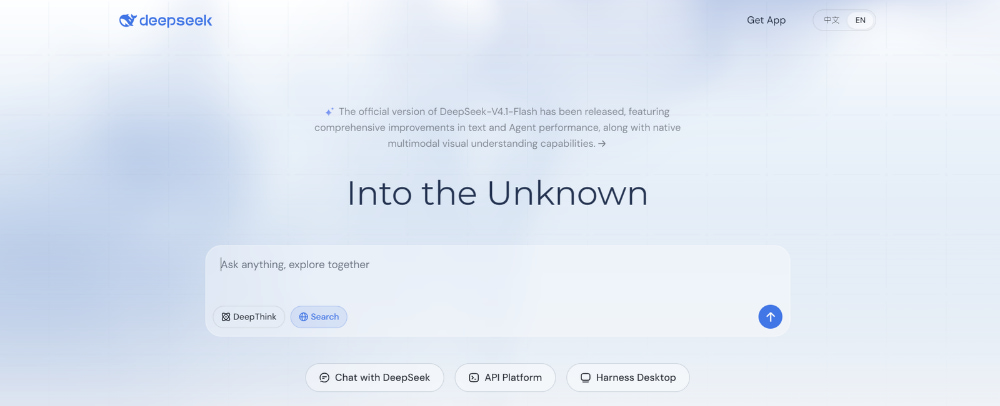
Deepseek官方網站
DeepSeek 主要創新核心技術
DeepSeek 的模型持續更換架構。V3 與 R1 世代的重點是 MLA、MoE、FP8 訓練與 DualPipe;2026 年推出的 V4 系列則加入 DeepSeek Sparse Attention(DSA)等新設計,把上下文擴大到 100 萬 token,並強化工具呼叫、程式開發與代理任務。以下技術要分世代理解,不能把 V3 的規格直接當成目前所有 DeepSeek 模型的規格。
多頭注意力 Multi-head Latent Attention (MLA)
-
目標:讓電腦處理很長的文字時,減少記憶體的使用,並且加快處理速度。
-
方法:MLA 透過壓縮注意力所需的 key-value 表示,降低長文本推理時的記憶體與運算負擔。這是 V3、R1 世代的重要設計;現行 V4 系列已採用 DSA 等新架構,不能再用 MLA 概括最新模型。
-
應用:適合處理很長的文章或對話,比如法律文件或多輪對話。
混合專家(MoE)架構
-
目標:讓電腦在處理複雜任務時更有效率。
-
方法:MoE 會在每個 token 只啟動部分專家參數,不必每次動用整個模型。V3 與 R1 的主模型是 671B 總參數、每個 token 約啟動 37B;V4-Pro 為 1.6T 總參數、49B 啟動,V4-Flash 為 284B 總參數、13B 啟動。
-
特點:這樣的好處是,電腦跑得更快,而且還更省電、更省錢。
FP8 高效能使用記憶體
-
目標:讓電腦在訓練模型時,減少記憶體使用並加快運算速度。
-
方法:DeepSeek-V3 採用 FP8 混合精度訓練,目的是降低記憶體與運算成本。這項說法描述的是 V3 訓練架構,不代表現行所有模型都使用完全相同的精度配置。
-
通訊優化:在多個 GPU 之間傳輸資料時,使用一種叫做「DualPipe」的技術,讓資料傳輸更順暢,減少等待時間,提升整體效率。
什麼是 AGI?
AGI 是「人工通用智慧」的英文簡寫,全名為 Artificial General Intelligence,通常指能跨領域理解、學習並處理多種任務的 AI。AGI 並沒有一致公認的測試標準,也不等於一定具有自我意識。目前公開的 DeepSeek、ChatGPT、Gemini 等產品仍是依模型、資料與工具完成特定任務,不能直接認定為 AGI。
DeepSeek- V3、DeepSeek- R1的比較
DeepSeek-V3 於 2024 年 12 月發布,DeepSeek-R1 於 2025 年 1 月發布。R1 延續 V3 的基礎架構,主要差別在後訓練與強化學習,目標是提升數學、程式與複雜推理能力;V3 則是一般用途模型。這張表保留兩個重要歷史版本的差異,但目前 DeepSeek 官方 API 已更新為 V4.1-Flash 與 V4-Pro。
DeepSeek- V3、DeepSeek- R1 的比較表
| 特性 | Deepseek-V3 | Deep Seek-R1 |
|---|---|---|
| 模型規模 | 總參數量 671B(約 6,710 億),MoE 架構,每個 token 約啟動 37B 參數 | 完整 R1 主模型以 DeepSeek-V3-Base 為基礎,同為 671B 總參數、每個 token 約啟動 37B |
| 創新技術 | Moe架構的效能提升,結合多階段的數據優化,大規模預先訓練 | 使用GRPO方式進行RL訓練,針對沒有微調的模型提升性能,改進了推理能力 |
| 性能表現 | 官方 V3 報告顯示,它在多項知識、數學與程式基準優於當時多數開放權重模型 | 官方 R1 報告顯示,它在數學、程式與部分推理基準接近當時的 OpenAI o1-1217;這是 2025 年發布時的比較,不代表目前模型排名。 |
| 訓練方法 | 採用強化學習(RL)、監督微調(SFT)、預先訓練用了14.8兆的文本進行預訓練。 | 採用多階段訓練模式,冷啟動微調,再使用強化學習(RL)、監督微調(SFT) |
| 訓練成本 | 官方報告公布 V3 完整訓練約使用 2.788M H800 GPU 小時;常見的 557.6 萬美元是依 GPU 租用單價換算,不等於公司全部研發成本 | 官方沒有公布可直接與 V3 完整比較的 R1 總研發成本 |
| 應用功能 | 文本生成、語文理解、文字翻譯,適用於NLP任務 | 應用用在比較深度的一些推理任務,像是數學解題、程式碼撰寫、複雜問題分析 |
| 本地端架設 | 支援本地部署,有軟硬體配置說明。 | 支援本地部署,有軟硬體配置說明。 |
(手機版表格可左右滑動)
什麼是NLP?
NLP 的英文全名是 Natural Language Processing,也就是「自然語言處理」的意思!簡單來說,自然語言處理(NLP)是一種讓電腦能「讀懂」和「處理」人類語言的技術。現在,很多公司都有大量的文字和語音資料,像是電子郵件、簡訊、社群媒體貼文等等,NLP 就是幫助他們從這些資料中提取有用資訊的工具。
DeepSeek 跟 ChatGPT 有什麼不一樣?
DeepSeek 是公司、模型家族與 AI 服務品牌;ChatGPT 是 OpenAI 的 AI 服務,背後會隨版本使用不同 GPT 模型。兩者都能對話、推理、處理檔案與協助寫程式,但模型來源、開放方式、資料政策和計價方式不同。以下資訊以 2026 年 10 月 8 日官方頁面為準。
DeepSeek、ChatGPT 比較表
| 項目 | DeepSeek | ChatGPT |
|---|---|---|
| 開發公司 | 深度求索(中國) | OpenAI(美國) |
| 成立時間 | 2023年 | 2015年 |
| 開發時間 | 較新,技術仍在快速發展中 | 產品與模型持續更新;ChatGPT 目前使用 GPT-6 系列,模型依方案與地區逐步提供 |
| 開發成本 | 公司未公開完整研發成本 | OpenAI 未公開 ChatGPT 與各代 GPT 模型的完整研發成本 |
| 訓練成本 | V3 官方公布 2.788M H800 GPU 小時;約 557.6 萬美元是運算租用成本估算,不是全部研發成本 | OpenAI 未公布可直接對照的 GPT-4o 完整訓練成本 |
| 目標 | 推進通用人工智慧(AGI)研究,提供模型、聊天服務與 API | 提供通用 AI 模型與 ChatGPT 產品服務 |
| 核心技術 | MoE、DSA、長上下文、思考模式與代理工具 | GPT 系列模型、多模態理解、推理與工具使用 |
| 語言優勢 | 中英文與程式能力均強,中文產品體驗完整 | 多語言與多模態能力完整,英文資料與全球服務成熟 |
| 開源情況 | V3、R1、V4/V4.1 等多代模型提供開放權重與技術報告;官方 API 收費 | 早期 GPT-2 提供開放權重;現行 GPT-6 系列為專有模型,API 收費 |
| 免費版 | 官方網頁與 App 可免費使用,實際額度與功能以產品頁為準 | 有 Free 方案,可使用日常對話;模型與工具額度依官方方案調整 |
| 付費版 | 官方聊天服務可免費使用;API 依 token 與尖峰/離峰時段計費 | ChatGPT Plus 每月 20 美元;API 使用另行計費 |
| API價錢 | 每百萬 token:V4.1-Flash 非快取輸入離峰/尖峰 0.15/0.30 美元,輸出 0.60/1.20 美元;V4-Pro 非快取輸入 0.66/1.32 美元,輸出 1.98/3.96 美元 | 每百萬 token:GPT-6 Luna 輸入/輸出 0.10/0.50 美元;GPT-6.1 Sol 為 2/10 美元;GPT-6 Astra 為 10/50 美元 |
| 應用場景 | 長文本、推理、程式開發、工具呼叫、視覺理解與中文應用 | 多模態對話、內容工作、研究、程式開發與代理任務 |
| 對話能力 | 強調多輪對話和複雜問題解決 | 擅長生成連貫、自然的對話內容 |
| 文本生成能力 | 支援中英文、程式與長文本生成 | 支援多語言、程式與多模態內容生成 |
| 翻譯能力 | 可處理多語翻譯,中文表現是常見優勢 | 可處理多語翻譯,全球語言覆蓋較完整 |
| 企業合作 | 提供全球網頁、App、API 與開放權重生態 | 全球範圍內合作,企業應用廣泛 |
| 未來發展 | V4.1 已加入原生視覺理解,持續擴充代理與開發者能力 | GPT-6 系列持續整合推理、多模態、工具與代理能力 |
| 硬體需求 | 官方 API/雲端服務不需自行準備 GPU;本地部署大型開放權重模型仍需大量硬體 | ChatGPT/API 不需使用者自備 GPU;模型訓練與服務由 OpenAI 基礎設施負責 |
| 數據來源 | 官方公開部分訓練方法與技術報告,但沒有完整公布所有訓練資料 | OpenAI 公開資料來源類型與資料政策,但未提供完整逐筆訓練資料清單 |
| 用戶評價 | 全球使用量與開發者生態已快速擴大,仍須評估資安、隱私與服務限制 | 全球用戶與企業採用成熟,功能、價格與額度會持續調整 |
(手機版表格可左右滑動)
DeepSeek 與其他 LLM 的評測
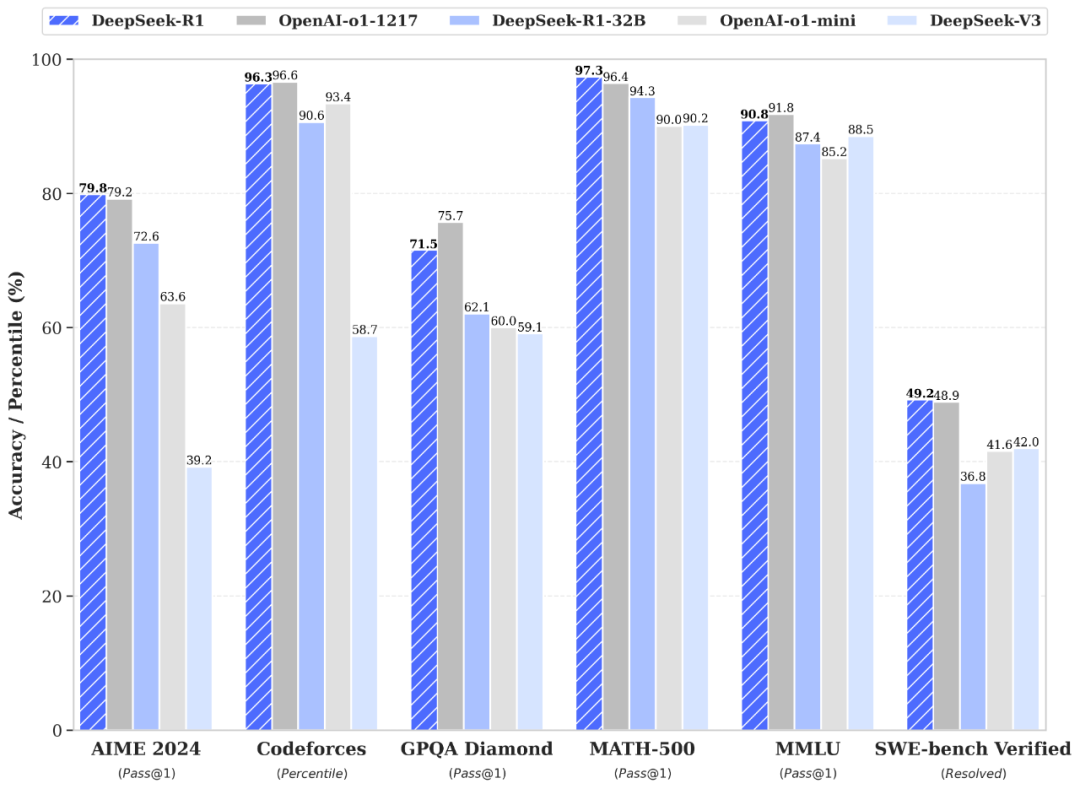
下方圖片是 DeepSeek-R1 在 2025 年發布時的官方評測,適合用來理解 R1 當時在數學、程式與推理方面的定位,但不能代表 2026 年最新模型排名。截至 2026 年 10 月,DeepSeek 已推出 V4.1-Flash 與 V4-Pro;OpenAI 也已更新到 GPT-6 系列,跨年份基準不能直接當成現在的勝負結論。
DeepSeek 與其他 AI 評測比較(2025年)
【圖片來源:https://api-docs.deepseek.com/】
DeepSeek API 要花多少錢?
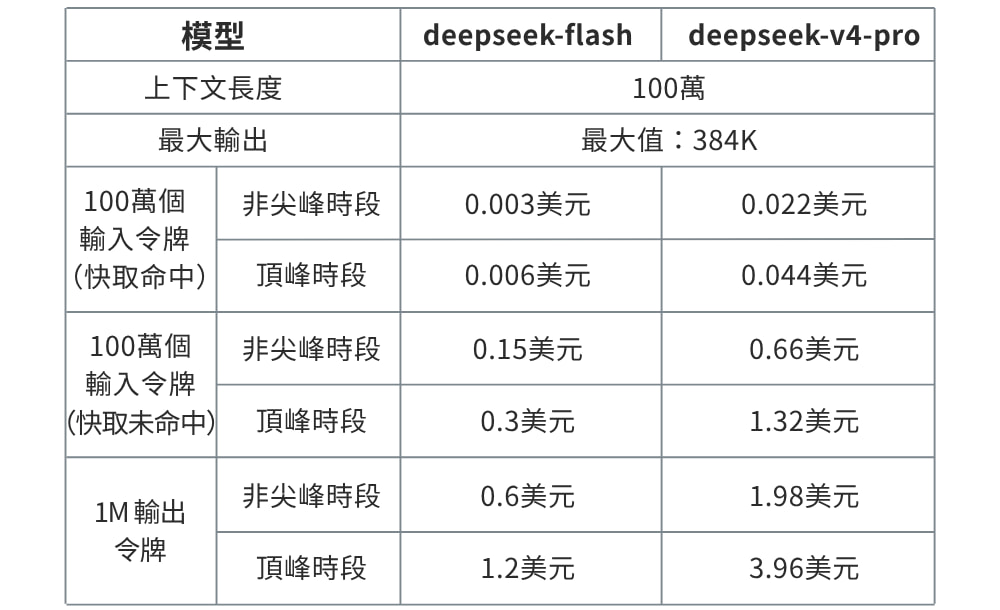
DeepSeek API 以每百萬 token 計價。token 是模型處理文字的基本單位,輸入、快取命中與輸出會分開計費。截至 2026 年 10 月 8 日,DeepSeek-V4.1-Flash 非快取輸入每百萬 token 為離峰 0.15 美元、尖峰 0.30 美元,輸出為離峰 0.60 美元、尖峰 1.20 美元;DeepSeek-V4-Pro 非快取輸入為 0.66/1.32 美元,輸出為 1.98/3.96 美元。下方圖片是舊版價格截圖,現行費用請以官方價格頁為準。
DeepSeek API 費用表
【資料來源:https://api-docs.deepseek.com/】
DeepSeek 的各種爭議
DeepSeek 是一家崛起很快的 AI 公司,技術和產品都很吸睛,但它在發展過程中也捲入了不少爭議,主要可以分成以下幾個爭議:
抄襲風波
OpenAI 曾公開表示,正在調查 DeepSeek 是否以模型蒸餾方式使用 OpenAI 的輸出;這屬於指控與調查,不等於已完成司法或監管認定。文章不應直接寫成 DeepSeek 已抄襲,也不能把尚未公開的訓練流程當成確定事實。
資料來源疑雲
DeepSeek 沒有公布完整訓練資料清單,因此外界無法逐筆確認授權狀態。版權與模型輸出蒸餾問題仍有爭議,較準確的說法是「資料來源與授權缺乏完整公開」,而不是直接判定所有資料都未經授權。
安全隱患
國家資通安全研究院曾公布 DeepSeek 離線模型測試,指出安全防護與越獄攻擊防禦不足;數位發展部也提醒雲端服務涉及跨境傳輸與資訊外洩疑慮。企業若要使用,至少要避免輸入個資、客戶機密、原始程式碼與未公開文件,並先確認資料處理位置及內部規範。
政治與地區限制
臺灣行政院於 2025 年宣布公務機關全面禁用 DeepSeek AI 服務,包含雲端、App 與地端下載;數位發展部同時說明,目前沒有全面限制一般民眾使用,但提醒注意資安與隱私風險。其他國家與機構的限制範圍不同,不能概括成全球全面禁用。
什麼是 DeepSeek 開源?
DeepSeek 的「開放」主要是公開部分模型權重與技術報告,讓開發者可以下載、部署、研究與依授權條款修改。這不代表訓練資料、資料清理流程、線上服務程式碼與所有產品細節全部公開。對企業來說,開放權重的好處是可以自行部署、測試與控管資料流向;但模型很大,仍要評估 GPU、維運、授權、安全更新與內容治理成本。判斷能不能商用時,應查看每一個模型版本附帶的授權,而不是只看到「開源」兩個字就認為沒有條件。
如何使用 DeepSeek?
一般使用者可以直接使用 DeepSeek 網頁版,或從官方連結前往 App Store、Google Play 下載 App;官方說明聊天服務可免費使用。開發者則可使用 API,現行模型為 DeepSeek-V4.1-Flash 與 DeepSeek-V4-Pro,按 token 計費。
【DeepSeek網站版:https://chat.deepseek.com/】
對 SEO 有什麼影響?
DeepSeek 對 SEO 的影響不只在於中文生成能力,而是企業多了一個可用於關鍵字整理、搜尋意圖分類、內容大綱、程式輔助與資料分析的模型選項。真正影響排名的仍是內容是否正確、有用、能回答搜尋需求,不能把 AI 產文直接當成 SEO 成效。若要把網站內容、GSC 或客戶資料交給雲端模型分析,也要先處理個資、商業機密與資料跨境風險。
〈延伸閱讀:2026 AI SEO怎麼做?從搜尋排名到AI摘要的優化重點一次看!〉
對網站設計有什麼影響?
目前 AI 已能協助網站需求整理、資訊架構、文案、程式、測試與圖片理解。DeepSeek-V4.1-Flash 已支援原生視覺理解,可以看懂圖片與介面,但官方沒有把它定位成專門的圖片生成模型。實務上可用來檢查畫面、整理修改需求與協助寫程式,最終版型、品牌一致性、無障礙與轉換流程仍需要人工確認。
〈延伸閱讀:網站設計最重要的10件事,網頁設計公司不會告訴你實話〉
對AI市場有什麼影響?
DeepSeek 已經不是「剛出現、還不確定是否開放」的階段。2026 年的 V4 系列把 100 萬 token 上下文、思考模式、工具呼叫、代理能力與較低 API 價格帶進市場,確實讓其他模型供應商面臨價格與效率競爭。不過企業選模型不能只看每百萬 token 單價,還要比較實際任務準確度、輸出長度、延遲、資料政策、可用地區、服務穩定度與維運成本。低單價不一定等於整體成本最低。
結論
DeepSeek 已從 2025 年的 V3、R1 發展到 2026 年的 V4.1-Flash 與 V4-Pro,模型、API、App 與開放權重生態都更完整。它的優勢是成本、長上下文、推理與代理能力,風險則包含資料治理、資安、地區政策與版本變動。它不是一定取代 ChatGPT,也不是因為價格低就適合所有企業。實際選擇時,先拿自己的內容、程式或客服任務做測試,再比較準確度、總成本與資料風險;涉及個資或機密資料時,不要直接放進未經審核的雲端 AI 服務。
〈延伸閱讀:寫文案用ChatGPT好嗎?AI為SEO帶來什麼影響?〉
(本文為達文西數位科技所有,禁止轉載圖文)

 取得報價
 網站免費健診
