

DeepSeek(深度求索)是一家成立于 2023 年的中国 AI 公司,也是一系列大型语言模型与 AI 服务的名称。2025 年的 DeepSeek-V3、DeepSeek-R1 让市场注意到它的低成本训练与推理能力;截至 2026 年 10 月,官方 API 已更新到 DeepSeek-V4.1-Flash 与 DeepSeek-V4-Pro,支援 100 万 token 的上下文,以及一般回答与思考模式。这篇文章保留 V3、R1 的发展脉络,同时把现行模型、功能与价格更新为官方最新资料。
什么是大语言模型(LLM)?
大语言模型的英文是 Large Language Model,简称 LLM,是一种从大量文字与其他资料中学习规律、用来理解及生成内容的 AI 模型。ChatGPT 是 OpenAI 的 AI 服务,Gemini 是 Google 的模型与服务品牌,DeepSeek 则是公司、服务与模型家族的名称,三者不能直接当成同一层级的「模型名称」。
DeepSeek 是一家什么公司?
深度求索(DeepSeek)是一家成立于 2023 年的中国 AI 公司,官方长期目标是推进通用人工智慧(AGI)。产品包含网页与手机版 DeepSeek Chat、API 平台及可下载的模型权重;现行服务可用于文字与程式生成、推理、翻译、资料整理、工具呼叫与视觉理解。
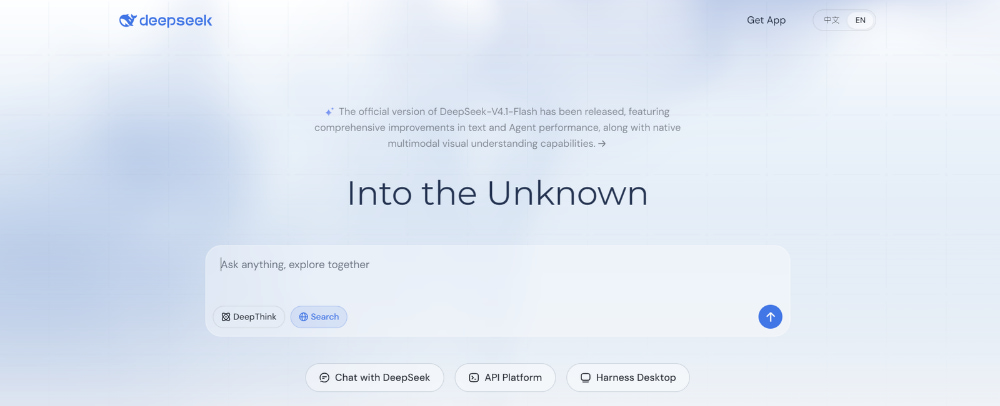
Deepseek官方网站
DeepSeek 主要创新核心技术
DeepSeek 的模型持续更换架构。V3 与 R1 世代的重点是 MLA、MoE、FP8 训练与 DualPipe;2026 年推出的 V4 系列则加入 DeepSeek Sparse Attention(DSA)等新设计,把上下文扩大到 100 万 token,并强化工具呼叫、程式开发与代理任务。以下技术要分世代理解,不能把 V3 的规格直接当成目前所有 DeepSeek 模型的规格。
多头注意力 Multi-head Latent Attention (MLA)
-
目标:让电脑处理很长的文字时,减少记忆体的使用,并且加快处理速度。
-
方法:MLA 透过压缩注意力所需的 key-value 表示,降低长文本推理时的记忆体与运算负担。这是 V3、R1 世代的重要设计;现行 V4 系列已採用 DSA 等新架构,不能再用 MLA 概括最新模型。
-
应用:适合处理很长的文章或对话,比如法律文件或多轮对话。
混合专家(MoE)架构
-
目标:让电脑在处理複杂任务时更有效率。
-
方法:MoE 会在每个 token 只启动部分专家参数,不必每次动用整个模型。V3 与 R1 的主模型是 671B 总参数、每个 token 约启动 37B;V4-Pro 为 1.6T 总参数、49B 启动,V4-Flash 为 284B 总参数、13B 启动。
-
特点:这样的好处是,电脑跑得更快,而且还更省电、更省钱。
FP8 高效能使用记忆体
-
目标:让电脑在训练模型时,减少记忆体使用并加快运算速度。
-
方法:DeepSeek-V3 採用 FP8 混合精度训练,目的是降低记忆体与运算成本。这项说法描述的是 V3 训练架构,不代表现行所有模型都使用完全相同的精度配置。
-
通讯优化:在多个 GPU 之间传输资料时,使用一种叫做「DualPipe」的技术,让资料传输更顺畅,减少等待时间,提升整体效率。
什么是 AGI?
AGI 是「人工通用智慧」的英文简写,全名为 Artificial General Intelligence,通常指能跨领域理解、学习并处理多种任务的 AI。AGI 并没有一致公认的测试标准,也不等于一定具有自我意识。目前公开的 DeepSeek、ChatGPT、Gemini 等产品仍是依模型、资料与工具完成特定任务,不能直接认定为 AGI。
DeepSeek- V3、DeepSeek- R1的比较
DeepSeek-V3 于 2024 年 12 月发布,DeepSeek-R1 于 2025 年 1 月发布。R1 延续 V3 的基础架构,主要差别在后训练与强化学习,目标是提升数学、程式与複杂推理能力;V3 则是一般用途模型。这张表保留两个重要历史版本的差异,但目前 DeepSeek 官方 API 已更新为 V4.1-Flash 与 V4-Pro。
DeepSeek- V3、DeepSeek- R1 的比较表
| 特性 | Deepseek-V3 | Deep Seek-R1 |
|---|---|---|
| 模型规模 | 总参数量 671B(约 6,710 亿),MoE 架构,每个 token 约启动 37B 参数 | 完整 R1 主模型以 DeepSeek-V3-Base 为基础,同为 671B 总参数、每个 token 约启动 37B |
| 创新技术 | Moe架构的效能提升,结合多阶段的数据优化,大规模预先训练 | 使用GRPO方式进行RL训练,针对没有微调的模型提升性能,改进了推理能力 |
| 性能表现 | 官方 V3 报告显示,它在多项知识、数学与程式基准优于当时多数开放权重模型 | 官方 R1 报告显示,它在数学、程式与部分推理基准接近当时的 OpenAI o1-1217;这是 2025 年发布时的比较,不代表目前模型排名。 |
| 训练方法 | 採用强化学习(RL)、监督微调(SFT)、预先训练用了14.8兆的文本进行预训练。 | 採用多阶段训练模式,冷启动微调,再使用强化学习(RL)、监督微调(SFT) |
| 训练成本 | 官方报告公布 V3 完整训练约使用 2.788M H800 GPU 小时;常见的 557.6 万美元是依 GPU 租用单价换算,不等于公司全部研发成本 | 官方没有公布可直接与 V3 完整比较的 R1 总研发成本 |
| 应用功能 | 文本生成、语文理解、文字翻译,适用于NLP任务 | 应用用在比较深度的一些推理任务,像是数学解题、程式码撰写、複杂问题分析 |
| 本地端架设 | 支援本地部署,有软硬体配置说明。 | 支援本地部署,有软硬体配置说明。 |
(手机版表格可左右滑动)
什么是NLP?
NLP 的英文全名是 Natural Language Processing,也就是「自然语言处理」的意思!简单来说,自然语言处理(NLP)是一种让电脑能「读懂」和「处理」人类语言的技术。现在,很多公司都有大量的文字和语音资料,像是电子邮件、简讯、社群媒体贴文等等,NLP 就是帮助他们从这些资料中提取有用资讯的工具。
DeepSeek 跟 ChatGPT 有什么不一样?
DeepSeek 是公司、模型家族与 AI 服务品牌;ChatGPT 是 OpenAI 的 AI 服务,背后会随版本使用不同 GPT 模型。两者都能对话、推理、处理档案与协助写程式,但模型来源、开放方式、资料政策和计价方式不同。以下资讯以 2026 年 10 月 8 日官方页面为准。
DeepSeek、ChatGPT 比较表
| 项目 | DeepSeek | ChatGPT |
|---|---|---|
| 开发公司 | 深度求索(中国) | OpenAI(美国) |
| 成立时间 | 2023年 | 2015年 |
| 开发时间 | 较新,技术仍在快速发展中 | 产品与模型持续更新;ChatGPT 目前使用 GPT-6 系列,模型依方案与地区逐步提供 |
| 开发成本 | 公司未公开完整研发成本 | OpenAI 未公开 ChatGPT 与各代 GPT 模型的完整研发成本 |
| 训练成本 | V3 官方公布 2.788M H800 GPU 小时;约 557.6 万美元是运算租用成本估算,不是全部研发成本 | OpenAI 未公布可直接对照的 GPT-4o 完整训练成本 |
| 目标 | 推进通用人工智慧(AGI)研究,提供模型、聊天服务与 API | 提供通用 AI 模型与 ChatGPT 产品服务 |
| 核心技术 | MoE、DSA、长上下文、思考模式与代理工具 | GPT 系列模型、多模态理解、推理与工具使用 |
| 语言优势 | 中英文与程式能力均强,中文产品体验完整 | 多语言与多模态能力完整,英文资料与全球服务成熟 |
| 开源情况 | V3、R1、V4/V4.1 等多代模型提供开放权重与技术报告;官方 API 收费 | 早期 GPT-2 提供开放权重;现行 GPT-6 系列为专有模型,API 收费 |
| 免费版 | 官方网页与 App 可免费使用,实际额度与功能以产品页为准 | 有 Free 方案,可使用日常对话;模型与工具额度依官方方案调整 |
| 付费版 | 官方聊天服务可免费使用;API 依 token 与尖峰/离峰时段计费 | ChatGPT Plus 每月 20 美元;API 使用另行计费 |
| API价钱 | 每百万 token:V4.1-Flash 非快取输入离峰/尖峰 0.15/0.30 美元,输出 0.60/1.20 美元;V4-Pro 非快取输入 0.66/1.32 美元,输出 1.98/3.96 美元 | 每百万 token:GPT-6 Luna 输入/输出 0.10/0.50 美元;GPT-6.1 Sol 为 2/10 美元;GPT-6 Astra 为 10/50 美元 |
| 应用场景 | 长文本、推理、程式开发、工具呼叫、视觉理解与中文应用 | 多模态对话、内容工作、研究、程式开发与代理任务 |
| 对话能力 | 强调多轮对话和複杂问题解决 | 擅长生成连贯、自然的对话内容 |
| 文本生成能力 | 支援中英文、程式与长文本生成 | 支援多语言、程式与多模态内容生成 |
| 翻译能力 | 可处理多语翻译,中文表现是常见优势 | 可处理多语翻译,全球语言复盖较完整 |
| 企业合作 | 提供全球网页、App、API 与开放权重生态 | 全球范围内合作,企业应用广泛 |
| 未来发展 | V4.1 已加入原生视觉理解,持续扩充代理与开发者能力 | GPT-6 系列持续整合推理、多模态、工具与代理能力 |
| 硬体需求 | 官方 API/云端服务不需自行准备 GPU;本地部署大型开放权重模型仍需大量硬体 | ChatGPT/API 不需使用者自备 GPU;模型训练与服务由 OpenAI 基础设施负责 |
| 数据来源 | 官方公开部分训练方法与技术报告,但没有完整公布所有训练资料 | OpenAI 公开资料来源类型与资料政策,但未提供完整逐笔训练资料清单 |
| 用户评价 | 全球使用量与开发者生态已快速扩大,仍须评估资安、隐私与服务限制 | 全球用户与企业採用成熟,功能、价格与额度会持续调整 |
(手机版表格可左右滑动)
DeepSeek 与其他 LLM 的评测
下方图片是 DeepSeek-R1 在 2025 年发布时的官方评测,适合用来理解 R1 当时在数学、程式与推理方面的定位,但不能代表 2026 年最新模型排名。截至 2026 年 10 月,DeepSeek 已推出 V4.1-Flash 与 V4-Pro;OpenAI 也已更新到 GPT-6 系列,跨年份基准不能直接当成现在的胜负结论。
DeepSeek 与其他 AI 评测比较(2025年)
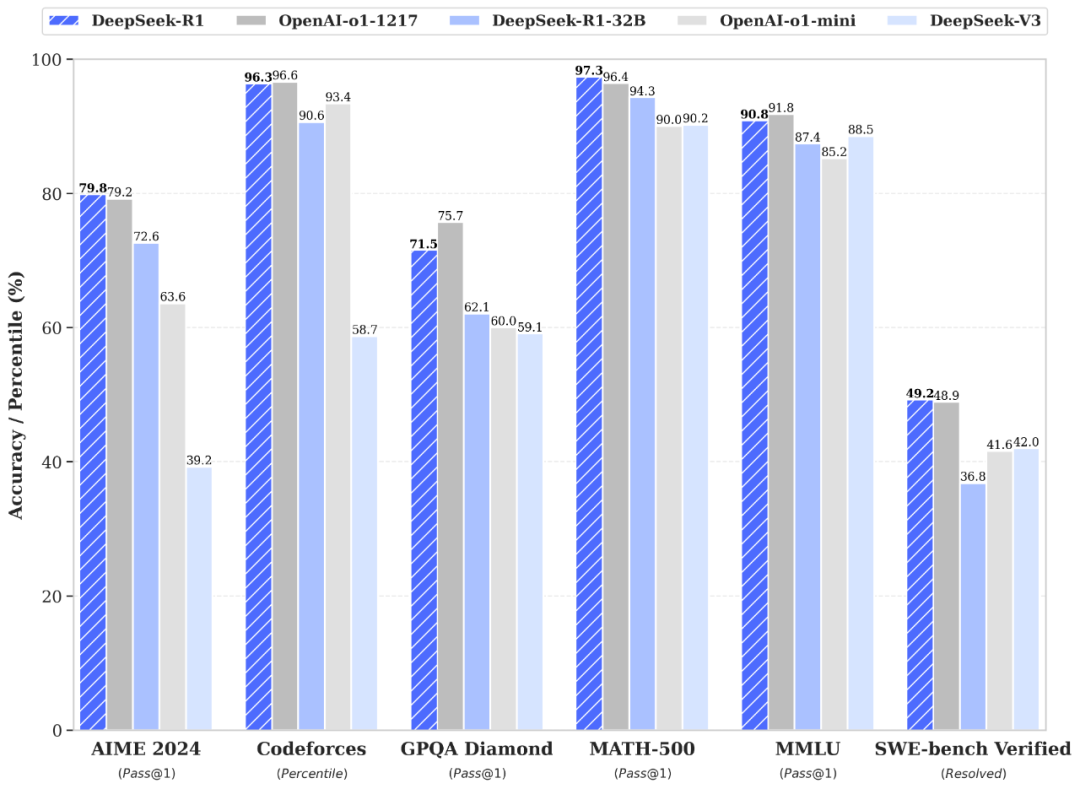
【图片来源:https://api-docs.deepseek.com/】
DeepSeek API 要花多少钱?
DeepSeek API 以每百万 token 计价。token 是模型处理文字的基本单位,输入、快取命中与输出会分开计费。截至 2026 年 10 月 8 日,DeepSeek-V4.1-Flash 非快取输入每百万 token 为离峰 0.15 美元、尖峰 0.30 美元,输出为离峰 0.60 美元、尖峰 1.20 美元;DeepSeek-V4-Pro 非快取输入为 0.66/1.32 美元,输出为 1.98/3.96 美元。下方图片是旧版价格截图,现行费用请以官方价格页为准。
DeepSeek API 费用表
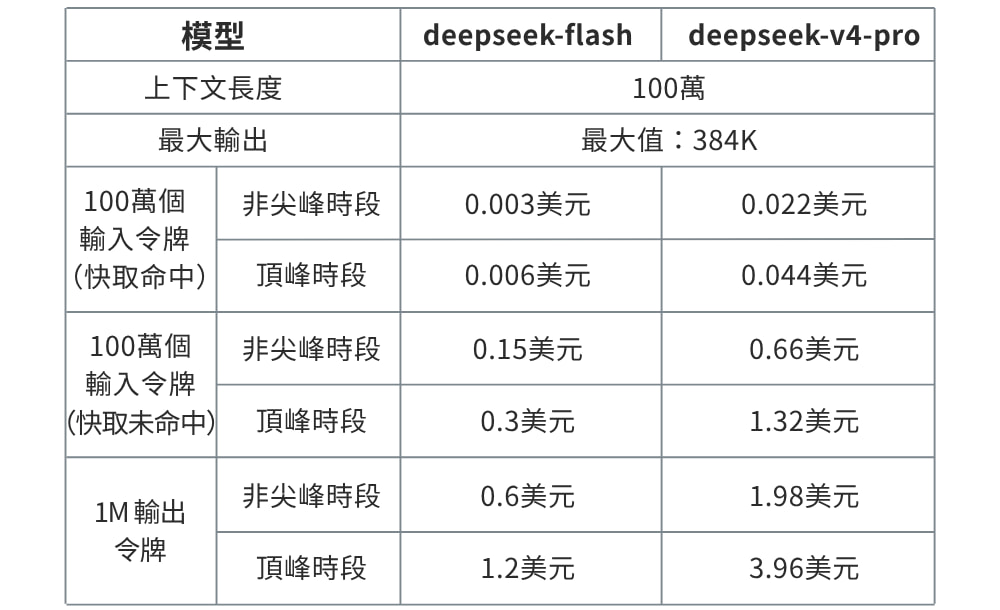
【资料来源:https://api-docs.deepseek.com/】
DeepSeek 的各种争议
DeepSeek 是一家崛起很快的 AI 公司,技术和产品都很吸睛,但它在发展过程中也捲入了不少争议,主要可以分成以下几个争议:
抄袭风波
OpenAI 曾公开表示,正在调查 DeepSeek 是否以模型蒸馏方式使用 OpenAI 的输出;这属于指控与调查,不等于已完成司法或监管认定。文章不应直接写成 DeepSeek 已抄袭,也不能把尚未公开的训练流程当成确定事实。
资料来源疑云
DeepSeek 没有公布完整训练资料清单,因此外界无法逐笔确认授权状态。版权与模型输出蒸馏问题仍有争议,较准确的说法是「资料来源与授权缺乏完整公开」,而不是直接判定所有资料都未经授权。
安全隐患
国家资通安全研究院曾公布 DeepSeek 离线模型测试,指出安全防护与越狱攻击防禦不足;数位发展部也提醒云端服务涉及跨境传输与资讯外洩疑虑。企业若要使用,至少要避免输入个资、客户机密、原始程式码与未公开文件,并先确认资料处理位置及内部规范。
政治与地区限制
臺湾行政院于 2025 年宣布公务机关全面禁用 DeepSeek AI 服务,包含云端、App 与地端下载;数位发展部同时说明,目前没有全面限制一般民众使用,但提醒注意资安与隐私风险。其他国家与机构的限制范围不同,不能概括成全球全面禁用。
什么是 DeepSeek 开源?
DeepSeek 的「开放」主要是公开部分模型权重与技术报告,让开发者可以下载、部署、研究与依授权条款修改。这不代表训练资料、资料清理流程、线上服务程式码与所有产品细节全部公开。对企业来说,开放权重的好处是可以自行部署、测试与控管资料流向;但模型很大,仍要评估 GPU、维运、授权、安全更新与内容治理成本。判断能不能商用时,应查看每一个模型版本附带的授权,而不是只看到「开源」两个字就认为没有条件。
如何使用 DeepSeek?
一般使用者可以直接使用 DeepSeek 网页版,或从官方连结前往 App Store、Google Play 下载 App;官方说明聊天服务可免费使用。开发者则可使用 API,现行模型为 DeepSeek-V4.1-Flash 与 DeepSeek-V4-Pro,按 token 计费。
【DeepSeek网站版:https://chat.deepseek.com/】
对 SEO 有什么影响?
DeepSeek 对 SEO 的影响不只在于中文生成能力,而是企业多了一个可用于关键字整理、搜寻意图分类、内容大纲、程式辅助与资料分析的模型选项。真正影响排名的仍是内容是否正确、有用、能回答搜寻需求,不能把 AI 产文直接当成 SEO 成效。若要把网站内容、GSC 或客户资料交给云端模型分析,也要先处理个资、商业机密与资料跨境风险。
〈延伸阅读:2026 AI SEO怎么做?从搜寻排名到AI摘要的优化重点一次看!〉
对网站设计有什么影响?
目前 AI 已能协助网站需求整理、资讯架构、文案、程式、测试与图片理解。DeepSeek-V4.1-Flash 已支援原生视觉理解,可以看懂图片与介面,但官方没有把它定位成专门的图片生成模型。实务上可用来检查画面、整理修改需求与协助写程式,最终版型、品牌一致性、无障碍与转换流程仍需要人工确认。
〈延伸阅读:网站设计最重要的10件事,网页设计公司不会告诉你实话〉
对AI市场有什么影响?
DeepSeek 已经不是「刚出现、还不确定是否开放」的阶段。2026 年的 V4 系列把 100 万 token 上下文、思考模式、工具呼叫、代理能力与较低 API 价格带进市场,确实让其他模型供应商面临价格与效率竞争。不过企业选模型不能只看每百万 token 单价,还要比较实际任务准确度、输出长度、延迟、资料政策、可用地区、服务稳定度与维运成本。低单价不一定等于整体成本最低。
结论
DeepSeek 已从 2025 年的 V3、R1 发展到 2026 年的 V4.1-Flash 与 V4-Pro,模型、API、App 与开放权重生态都更完整。它的优势是成本、长上下文、推理与代理能力,风险则包含资料治理、资安、地区政策与版本变动。它不是一定取代 ChatGPT,也不是因为价格低就适合所有企业。实际选择时,先拿自己的内容、程式或客服任务做测试,再比较准确度、总成本与资料风险;涉及个资或机密资料时,不要直接放进未经审核的云端 AI 服务。
〈延伸阅读:写文案用ChatGPT好吗?AI为SEO带来什么影响?〉
(本文为达文西数位科技所有,禁止转载图文)

 取得報價
 網站免費健診
